Responsables de mantenimiento: reduce MTTR en meses y mejora MTBF
2026-05-12
El MTTR (tiempo medio de reparación) mide cuánto tarda tu equipo en devolver una máquina al servicio tras un fallo. El MTBF (tiempo medio entre fallos) mide cuántas horas funciona esa máquina, en promedio, antes de fallar de nuevo. Juntos determinan la disponibilidad real de tus activos: disponibilidad = MTBF / (MTBF + MTTR). Cuanto más alto el MTBF y más bajo el MTTR, más horas productivas ganas sin comprar una sola máquina nueva.
En resumen:
Para mejorar la disponibilidad, es fundamental reducir el MTTR exigiendo una organización eficiente en la gestión de repuestos, procedimientos claros y capacitación técnica constante.
El MTBF se calcula excluyendo paradas programadas, considerando solo fallos internos, y es recomendable desglosar la medición por clase de activo o máquina para detectar problemas específicos.
La metodología más utilizada para el MTTR es la de registrar las fases de reparación, ya que identificar cuellos de botella en cada etapa permite acciones concretas y rápidas.
Un ratio superior a 200 entre MTBF y MTTR indica un sistema de activos saludable, mientras que valores bajos alertan sobre fallos frecuentes o reparaciones lentas.
Implementar sistemas CMMS o MES automatizados ayuda a obtener mediciones precisas y a optimizar los tiempos de reparación y la fiabilidad del equipo en tiempo real.
Tabla de contenidos
-
Benchmarks orientativos y factores que influyen en los valores
-
Prioridades y hoja de ruta: cuándo atacar el MTTR y cuándo el MTBF
¿Qué es el MTBF? definición, fórmula y límites
El MTBF se aplica a activos reparables: bombas, motores, líneas de envasado, cualquier equipo que se arregla y vuelve a funcionar en lugar de sustituirse. La fórmula es sencilla:
MTBF = tiempo total de funcionamiento ÷ número de fallos
Si una prensa funciona un número significativo de horas al año y falla varias veces, su MTBF se calcula dividiendo el total de horas de funcionamiento entre el número de fallos. El detalle que casi nadie explica bien: las paradas programadas de mantenimiento preventivo no cuentan como fallos y deben excluirse del cálculo, porque si las mezclas, obtienes un MTBF artificialmente bajo que no refleja la fiabilidad real del equipo.
El MTBF tiene límites que conviene conocer antes de usarlo para tomar decisiones:
-
Es un promedio estadístico, no una predicción exacta: un MTBF de 900 horas no significa que la máquina fallará puntualmente cada 900 horas.
-
Depende de cómo defines «fallo»: una parada por falta de suministro eléctrico externo no es lo mismo que una avería mecánica interna, y mezclar ambas distorsiona la métrica.
-
Un MTBF calculado sobre un parque completo de máquinas oculta a los activos problemáticos que arrastran el promedio hacia abajo.
Consejo profesional: calcula el MTBF por clase de activo (todas las bombas centrífugas) y también por unidad individual. Si una bomba concreta tiene un MTBF muy por debajo de su clase, tienes un candidato claro para análisis de causa raíz antes de que arrastre el indicador global.
¿Qué es el MTTR? variantes, fases y fórmula práctica
La «R» de MTTR no siempre significa lo mismo, y confundir las variantes lleva a comparar cifras que no son comparables:
-
Reparación (repair): tiempo desde que empieza la intervención técnica hasta que la máquina vuelve a funcionar.
-
Recuperación (recovera): incluye también la restauración de procesos o datos asociados, típico en entornos con sistemas de control.
-
Resolución (resuelve): abarca hasta que el problema queda cerrado y documentado, no solo reparado.
-
Respuesta (responde): mide solo el tiempo hasta que un técnico atiende el aviso, sin contar la reparación en sí.
Para mantenimiento industrial, la variante más usada es la de reparación, y su fórmula operativa es:
MTTR = tiempo total de reparación ÷ número de incidentes
Pero el número global esconde el problema real. El desglose por fases sí es accionable: detección del fallo, diagnóstico de la causa, espera de repuestos, reparación física y verificación antes de volver a producción. Cada fase tiene una palanca distinta: la detección mejora con sensores y alarmas, el diagnóstico con historiales de averías, la espera de repuestos con gestión de stock, y la verificación con checklists estandarizados.
Consejo profesional: registra la marca de tiempo de cada fase, no solo el inicio y el final de la intervención. Un [object Object] revela si tu problema real es la burocracia de aviso, la falta de repuestos en almacén o la falta de formación técnica, y cada uno se ataca de forma distinta.
Sin ese registro por fases, cualquier análisis de MTTR es una caja negra: sabes que algo tarda demasiado, pero no sabes qué parte del proceso lo está causando.
Cálculo de MTTR y MTBF: un ejemplo paso a paso
Toma una línea de envasado que funciona 20 horas al día, 6 días a la semana, durante un mes:
-
Horas de operación planificadas en el mes: 480 horas.
-
Número de fallos registrados: 4.
-
Horas totales dedicadas a reparación (suma de las 4 intervenciones): 12 horas.
Con estos datos, el cálculo del MTBF es directo: tiempo de funcionamiento efectivo dividido entre número de fallos. Si restas las 12 horas de parada a las 480 planificadas, obtienes 468 horas de funcionamiento real repartidas entre 4 fallos, es decir, MTBF = 117 horas.
El MTTR se calcula sobre las horas de reparación entre el número de incidentes: 12 horas ÷ 4 fallos = MTTR = 3 horas.
Esa cifra significa que, de cada 100 horas que la línea debería estar produciendo, 97,5 lo hace efectivamente. El resto son horas perdidas por averías, no por paradas planificadas ni por falta de pedidos.
Para adaptar este cálculo a tu planta, sustituye las horas de operación y el número de fallos por los datos reales de un activo o clase de activos durante un periodo representativo, idealmente un trimestre completo para suavizar picos puntuales de avería.
MTBF frente a MTTF y otras métricas: MTTA, OEE
MTBF y MTTF (tiempo medio hasta el fallo) suenan casi idénticos pero se aplican a cosas distintas. MTBF es exclusivo de activos reparables: la bomba se arregla y sigue funcionando, así que puede fallar varias veces y acumular varios intervalos entre fallos. MTTF se usa para componentes no reparables que se sustituyen al fallar, como un rodamiento sellado o una bombilla industrial: no hay «entre fallos» porque solo falla una vez y termina su vida útil.
Otras métricas completan el panorama:
-
MTTA (tiempo medio hasta el reconocimiento): mide cuánto tarda un técnico en confirmar que ha recibido la alerta de avería, antes incluso de empezar a diagnosticar. Es la fase de detección del MTTR aislada como indicador propio.
-
OEE (eficiencia global del equipo): combina disponibilidad, rendimiento y calidad. La disponibilidad que calculas con MTBF y MTTR alimenta directamente uno de los tres factores del OEE.
La recomendación práctica es no perseguir las cinco métricas a la vez. Empieza por MTTR y MTBF, que son la base de la disponibilidad, y añade MTTA cuando quieras afinar específicamente los tiempos de reacción de tus equipos de guardia.
Benchmarks orientativos y factores que influyen en los valores
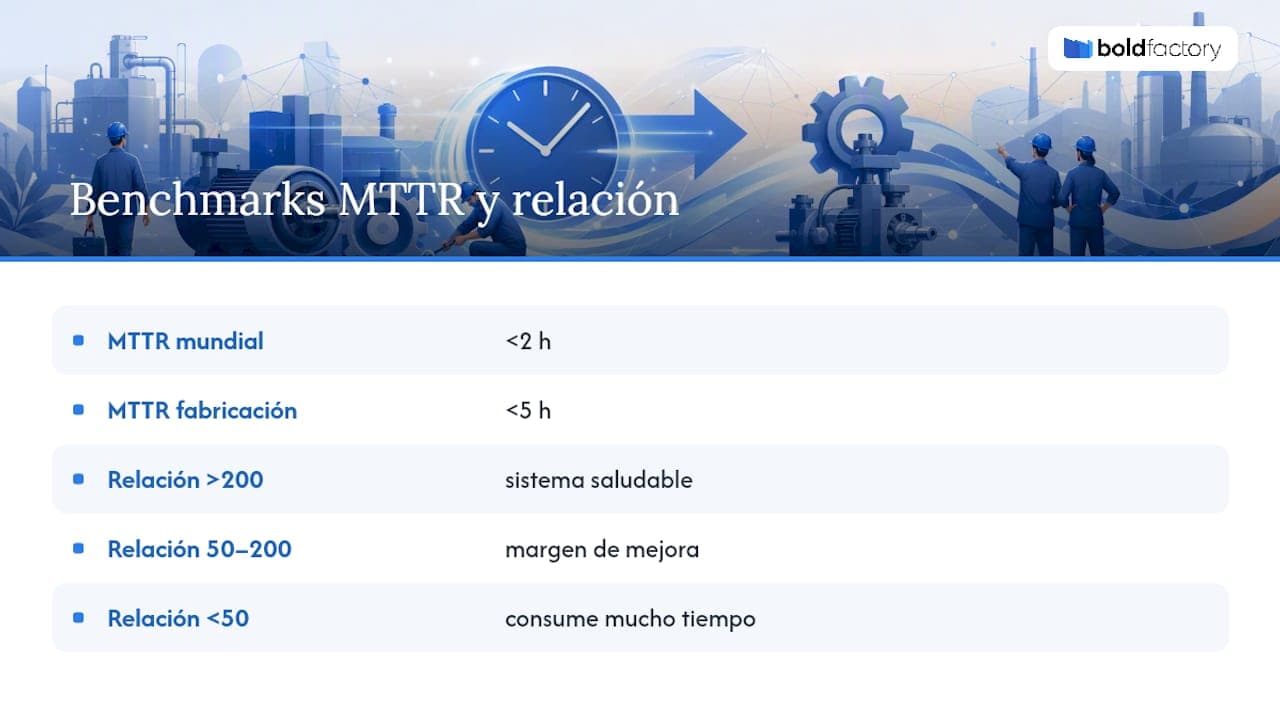
Los rangos de referencia varían tanto por tipo de activo que citarlos sin contexto es engañoso. Un MTTR de clase mundial puede situarse por debajo de 2 horas, y para fabricación general una referencia práctica habitual es mantenerse por debajo de 5 horas, aunque el número exacto depende del tipo de equipo y de la complejidad de la reparación.
Una CNC con control numérico propietario y un servidor con piezas estándar no son comparables: el primero puede necesitar soporte del fabricante, el segundo se sustituye con un repuesto de almacén en minutos.
Regla práctica: la relación MTBF/MTTR importa más que los valores absolutos. Como referencia orientativa, una relación superior a 200 suele indicar un sistema saludable, entre 50 y 200 sugiere margen de mejora, y por debajo de 50 apunta a un activo que consume desproporcionadamente el tiempo del equipo de mantenimiento.
Antes de fijar un objetivo, normaliza por horas de uso real y por criticidad del activo. Una máquina que solo trabaja 4 horas al día no debería compararse con una que opera en tres turnos: la exposición al desgaste es distinta y el benchmark debe ajustarse en consecuencia.
Medidas prácticas para reducir el MTTR en pocos meses
Reducir el MTTR es la ganancia rápida: no exige rediseñar máquinas, exige ordenar el proceso de reacción.
-
Reposiciona los repuestos críticos. Identifica qué piezas provocan más horas de espera y ponlas físicamente cerca del activo, no en un almacén central a 20 minutos.
-
Estandariza procedimientos con checklists. Una reparación documentada paso a paso evita que cada técnico improvise su propio método y reduce variabilidad en los tiempos.
-
Forma y rota técnicos para lograr el «first-time fix». Cada reintervención por diagnóstico incorrecto duplica el tiempo total de parada.
-
Rediseña para facilitar el acceso. Paneles con tornillería estándar, puntos de test accesibles y manuales visibles en la propia máquina recortan minutos en cada fase.
-
Usa un sistema que priorice y guíe la intervención. Un GMAO/CMMS que muestre historial de averías y ubicación de repuestos evita que el técnico pierda tiempo buscando información antes de actuar.
Consejo profesional: mide el MTTR por fase durante un trimestre antes de invertir en nada.
Estrategias para aumentar el MTBF a medio y largo plazo
Aumentar el MTBF es un programa, no una acción puntual. Exige entender por qué falla el equipo, no solo repararlo más rápido cuando falla.
-
Análisis de causa raíz en fallos recurrentes. Si la misma bomba falla por la misma razón cada dos meses, el problema no es la reparación, es el diseño de la instalación o un parámetro operativo mal ajustado.
-
Mantenimiento basado en condición. Sensores de vibración, temperatura o consumo eléctrico permiten intervenir antes de que el fallo ocurra, en lugar de reaccionar después.
-
Revisión de especificaciones con el fabricante (OEM). A veces el equipo trabaja fuera de sus parámetros de diseño y el proveedor puede recomendar ajustes que reducen el desgaste.
-
Ajuste de planes de mantenimiento preventivo. Revisar periódicamente los intervalos de intervención evita tanto el exceso de mantenimiento como el defecto, ambos costosos.
-
Coordinación con planificación de producción. Un módulo de planificación MRP que reparta la carga entre máquinas evita que un equipo trabaje siempre al límite mientras otro queda infrautilizado, algo que acelera el desgaste del primero sin necesidad.
Mejorar el MTTR es táctico. Mejorar el MTBF exige análisis de causa raíz y trabajo de ingeniería sostenido, y los resultados tardan meses en notarse, no semanas.
Cómo un CMMS/MES facilita medir y mejorar MTTR y MTBF
Un sistema de gestión de mantenimiento captura de forma automática los datos que antes vivían en partes de trabajo en papel: hora de aviso, hora de inicio de diagnóstico, hora de llegada del repuesto, hora de cierre. Ese registro por fases es exactamente lo que permite calcular MTTR y MTBF sin depender de estimaciones a ojo.
Los flujos de trabajo digitales reducen tiempos de espera de forma concreta:
-
Alertas automáticas cuando un sensor de condición detecta una desviación, antes de que el fallo se produzca.
-
Historial de averías por máquina que acelera el diagnóstico en la segunda visita a un mismo problema.
-
Visibilidad de stock de repuestos críticos vinculada directamente a cada activo, para no perder tiempo buscando dónde está la pieza.
-
Órdenes de trabajo priorizadas según criticidad del equipo, evitando que una avería menor bloquee la agenda de una avería mayor.
Un MES integrado con el control de producción además cruza los datos de parada con los de producción real, lo que permite distinguir un fallo mecánico de una simple espera de material. Esa distinción es la que separa un MTBF fiable de uno inflado por causas ajenas al equipo.
Prioridades y hoja de ruta: cuándo atacar el MTTR y cuándo el MTBF
Si tu equipo vive apagando incendios, empieza por el MTTR: repuestos mal posicionados y falta de checklists se corrigen en semanas. Pero cuidado con un error común: bajar el MTTR sin subir el MTBF puede enmascarar un problema de fiabilidad y convertir a tu equipo en expertos en reparar rápido lo que nunca debería fallar tanto.
Un roadmap razonable fija objetivos trimestrales de MTTR (reducir tiempos de espera de repuestos, formar técnicos) mientras arranca en paralelo un programa de 1 a 3 años centrado en causa raíz y mantenimiento basado en condición. Ninguna de las dos métricas se sostiene sola.
Bold Factory es la alternativa a construir tu propio sistema de seguimiento en Excel: el módulo de GMAO/CMMS registra automáticamente cada fase de la intervención (aviso, diagnóstico, espera de repuesto, reparación, verificación), así que MTTR y MTBF salen calculados solos, por activo y por clase de activo, sin que nadie tenga que teclear horas manualmente al final del turno.
El MES cruza esos tiempos de parada con los datos reales de producción, y los agentes de inteligencia artificial de la plataforma automatizan avisos y priorización de órdenes de trabajo mediante instrucciones en lenguaje natural, sin necesidad de programar nada. Todo se implementa en días, sin permanencia obligatoria y con una interfaz pensada para que cualquier operario la use desde el móvil en planta.
Si gestionas una pyme industrial y quieres ver estos cálculos aplicados a tus propios activos, solicita una demo para comprobar cómo queda tu disponibilidad real en las primeras semanas de uso.