La interfaz de usuario en la era agéntica
2026-10-15
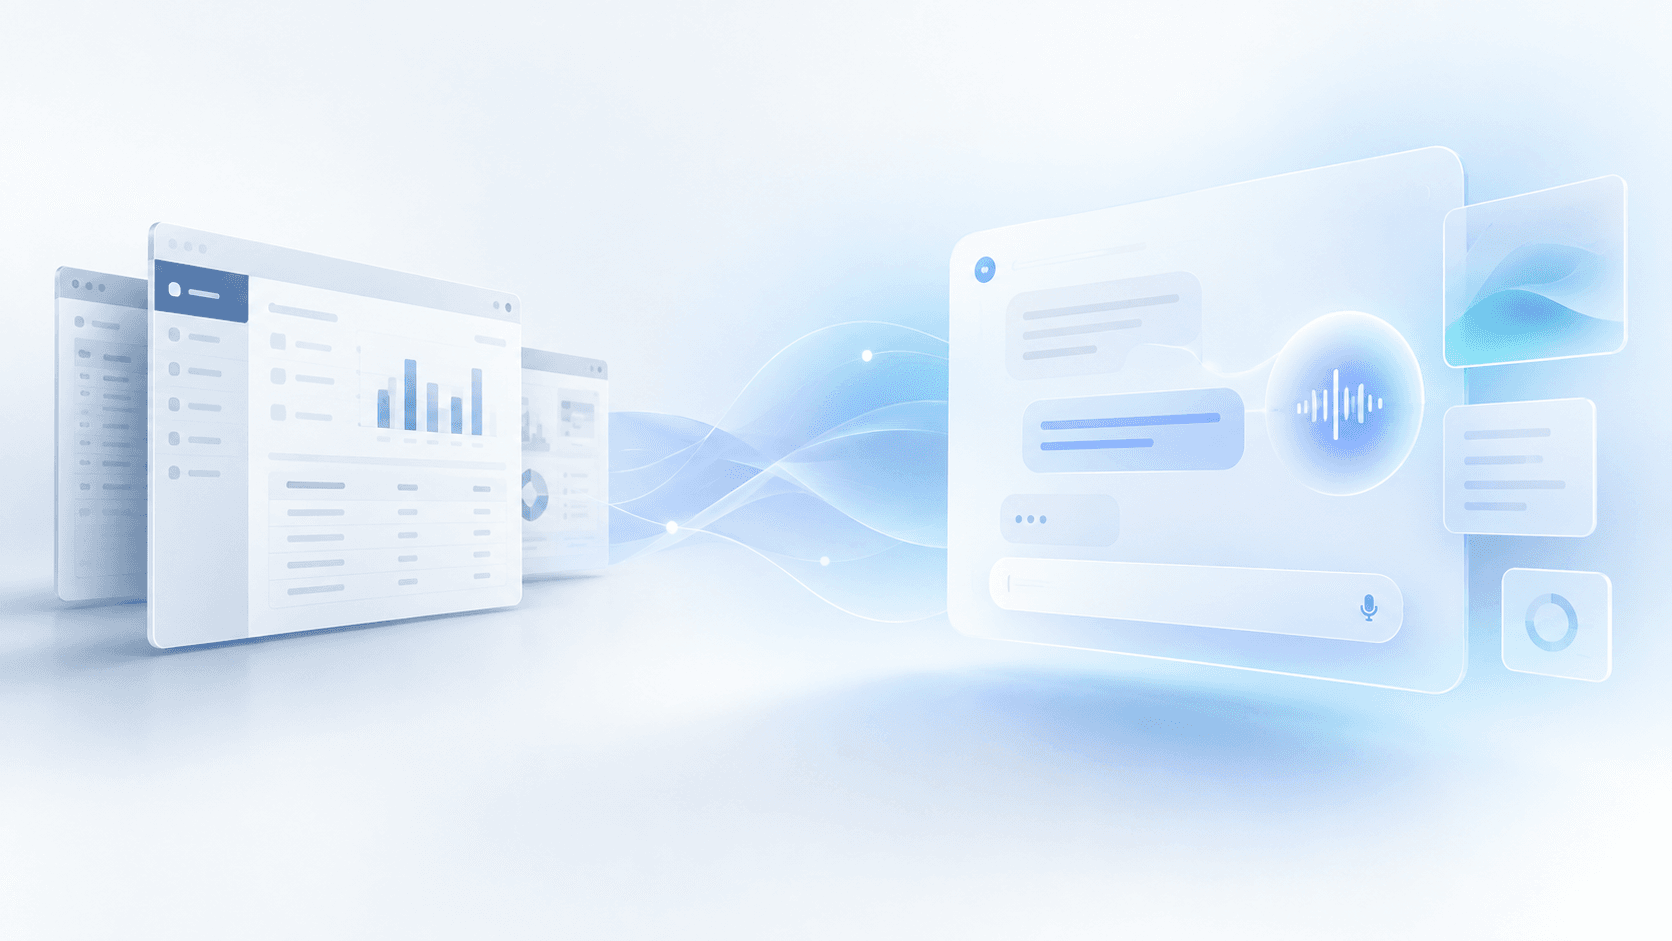
Generar una pantalla ya es barato: basta con describirle a un agente de IA lo que necesitas para tener delante, en unos minutos, una tabla con filtros, un par de gráficos y los botones justos. Usarla, compartirla y mantenerla, no: conseguir que el equipo sepa leerla, que un jefe de turno pueda decirle a otro dónde encontrar un dato y que siga diciendo la verdad cuando el producto cambie por debajo sigue costando lo de siempre.
Lo que vas a encontrar aquí
- Construir ya no es el cuello de botella
- Dónde ocurre la interacción no es lo mismo que cómo es la interfaz
- Tres formas de construir una interfaz
- El verdadero reto: mantener todo lo que generamos
- De una pantalla puntual a una funcionalidad del producto
- Lo que queremos explorar en Bold
- Fuentes
Construir ya no es el cuello de botella
Durante décadas, la mayoría de aplicaciones han funcionado de forma parecida: un equipo diseña las pantallas y los usuarios aprenden a utilizarlas. No es necesariamente una mala solución. Diseñar una experiencia diferente para cada empresa, departamento o persona resultaba demasiado caro, así que hemos construido productos comunes y añadido las opciones de configuración que podíamos permitirnos.
Los agentes de IA empiezan a cuestionar ese equilibrio. Pueden utilizar herramientas, consultar datos, ejecutar acciones y escribir el código de una interfaz a partir de una descripción. Si cada vez resulta más barato construir y modificar pantallas, ¿seguirá teniendo sentido que todos trabajemos con las mismas?
La respuesta no depende únicamente de cuánto cueste generarlas. Que construir una interfaz sea barato no significa que utilizarla, entenderla, compartirla con otros o mantenerla también lo sea. Sospecho que buena parte del futuro de la UI se decidirá en esa diferencia, y sobre todo en la última: cuánto cuesta comprobar, cada vez que el producto cambia, que una interfaz sigue haciendo lo que debía.
Dónde ocurre la interacción no es lo mismo que cómo es la interfaz
Cuando imaginamos el software de los próximos años, solemos pensar en un asistente universal, como ChatGPT o Claude, que conoce nuestro contexto y opera las aplicaciones por nosotros. También podemos imaginar algo más continuista: aplicaciones especializadas que mantienen su interfaz e incorporan agentes capaces de trabajar dentro de ella. Son dos modelos distintos sobre dónde se produce la interacción, no necesariamente sobre cómo será la interfaz.
El asistente universal tiene una ventaja evidente: nuestros procesos no respetan los límites entre aplicaciones. Podemos necesitar consultar una venta, comprobar existencias y preparar una compra, todo en sistemas diferentes. Un agente capaz de coordinar esas acciones nos ahorraría bastante trabajo. Para quienes desarrollamos software aparece una tensión comercial: abrir las capacidades de nuestras aplicaciones a agentes externos puede hacerlas mucho más útiles, pero también supone ceder parte del control sobre la experiencia y la relación con el cliente. Habrá incentivos tanto para facilitar esa integración como para resistirse a ella. Volveré sobre esto al final, porque condiciona qué interfaces viven dentro de nuestro producto y cuáles fuera.
En cualquier caso, conversar no sustituye a ver. Si necesito reorganizar la planificación semanal de una fábrica, preferiré un Gantt donde identificar conflictos y mover operaciones, quizá mientras le pido al agente que calcule alternativas. Agentes e interfaces van a convivir. La pregunta sobre la que quiero detenerme es otra: si seguimos necesitando pantallas, ¿quién las construye, para cuántos y cuánto tiempo deberían durar?
Tres formas de construir una interfaz
Esas tres preguntas (quién, para cuántos, cuánto tiempo) son ejes independientes, y cualquier interfaz real ocupa una posición en cada uno. Para no perderme en la combinatoria, voy a describir las tres combinaciones que me parecen más representativas.
1. Diseñarla para muchos usuarios
Es el modelo tradicional. Un equipo investiga necesidades, diseña una experiencia común y mejora sus pantallas a medida que aprende de su uso. Tiene el inconveniente de que no todo el mundo trabaja igual, pero ofrece algo muy valioso: una interfaz familiar, optimizada y compartida. Sabemos dónde están las cosas, podemos formar a nuevos compañeros y el soporte puede ayudarnos sin descubrir una aplicación distinta en cada conversación.
Una buena interfaz diseñada no pierde su valor porque aparezcan los agentes. Si repetimos una operación cincuenta veces al día, nos interesa más la rapidez y la previsibilidad que la capacidad de improvisar una pantalla nueva.
2. Generarla cuando la necesitamos
Imaginemos que pedimos a un agente comparar la evolución de los retrasos de varios proveedores. En lugar de devolver un párrafo o enviarnos a una pantalla preexistente, podría generar una tabla con filtros, un gráfico y los controles necesarios para explorar los datos. Terminamos el análisis y esa interfaz desaparece. Los asistentes generalistas ya empiezan a ofrecer este tipo de respuestas interactivas; OpenAI, por ejemplo, lo explora con Intelligent UI.
Es una posibilidad muy potente para preguntas excepcionales, análisis exploratorios o necesidades que nadie había previsto cuando se diseñó el producto. Su límite está en lo que se repite: no quiero que mi panel de indicadores cambie de distribución cada mañana, quiero reconocerlo de un vistazo. Y eso nos lleva al siguiente modelo.
3. Generarla, conservarla y hacerla evolucionar
Una interfaz puede nacer de una petición concreta y convertirse después en una herramienta habitual. Un responsable de compras podría conservar un panel adaptado a sus proveedores; un jefe de turno, otro pensado para sus incidencias y las operaciones en curso. La aplicación seguiría proporcionando las mismas capacidades y reglas de negocio, pero no obligaría a todos a trabajar con las mismas pantallas.
La personalización profunda no es nueva. Lo novedoso sería reducir lo suficiente el coste de crearla y mantenerla para que dejara de reservarse a grandes clientes con presupuestos de desarrollo a medida. Eso abre dos posibilidades bastante diferentes: que un equipo de implantación construya interfaces con ayuda de agentes, o que los propios usuarios puedan crearlas y modificarlas. La primera parece mucho más fácil de introducir a corto plazo; la segunda exige resolver problemas adicionales de seguridad, soporte y diseño.
Porque no todo lo que un usuario pide es necesariamente lo que necesita. Diseñar una buena interfaz implica descubrir el proceso real, identificar casos que nadie había mencionado y tomar decisiones que quizá el usuario no sepa formular. Un agente puede ayudar con ese trabajo, pero generar lo pedido no equivale a haber diseñado bien la solución.
También existe un coste colectivo. Si cada operario ve una aplicación diferente, ¿cómo formamos al siguiente empleado? ¿Cómo le dice un jefe de turno a otro dónde encontrar un dato? Una biblioteca de componentes puede mantener la estética, pero no garantiza un vocabulario compartido. Por eso imagino muchas personalizaciones a nivel de empresa, departamento o rol, y bastante menos libertad individual de la que sugiere la idea de «una interfaz para cada persona».
El verdadero reto: mantener todo lo que generamos
Aquí aparece una objeción evidente. La historia del software empresarial está llena de personalizaciones que terminaron haciendo casi imposible actualizar los productos. Grandes implantaciones de ERP han acumulado extensiones, dependencias y cambios específicos que nadie se atrevía a tocar. ¿No estaríamos repitiendo el problema, esta vez a mayor velocidad?
La respuesta fácil sería decir que una buena arquitectura lo evita, pero eso no sería ninguna novedad. SAP lleva años impulsando su enfoque Clean Core: mantener el núcleo estándar y extenderlo mediante contratos e interfaces estables. Las plataformas low-code también llevan mucho tiempo ofreciendo componentes y mecanismos de personalización. Separar la lógica de negocio de su presentación es ingeniería de software bien conocida, no algo que hayamos descubierto gracias a la IA.
Lo que puede cambiar frente al low-code tradicional es cómo construimos y mantenemos esas personalizaciones. En lugar de depender de la configuración de un editor específico, podemos hacer que los agentes generen código convencional, que guardamos en Git, revisamos y probamos con las mismas herramientas que utilizamos para cualquier otra aplicación. El código sigue siendo nuestro aunque mañana cambiemos de agente. A cambio, recuperamos algo que el low-code intentaba evitar: cada cambio vuelve a pasar por una revisión de desarrollo. Por eso me parece más realista empezar por el equipo de implantación que por el usuario final.
La apuesta realmente diferente está en otro sitio: ¿por qué asumir que los agentes solo servirán para crear interfaces y no para mantenerlas? Si una personalización se construye sobre un SDK versionado y APIs públicas, cuando el producto evolucione otros agentes podrían identificar los cambios que la afectan, adaptar el código y ejecutar pruebas antes de desplegar una nueva versión.
Una buena arquitectura intentaría mantener la compatibilidad hacia atrás y limitar las migraciones a las interfaces realmente afectadas. Los agentes podrían encargarse de buena parte de ese trabajo, aunque siempre habría un coste de ejecución y validación. Y tendría que existir una responsabilidad clara: si ofrecemos interfaces personalizadas como parte de nuestro producto, debemos garantizar su mantenimiento dentro de unos límites definidos, y ese servicio tiene un coste que debemos contemplar. La automatización puede reducirlo mucho, pero no hacerlo desaparecer.
Más difícil todavía es comprobar que una migración preserva el comportamiento correcto. Una pantalla puede compilar, pasar pruebas visuales y continuar mostrando datos, pero dejar de representar correctamente las reglas del negocio.
Imaginemos que un agente construye una pantalla personalizada para mostrar las órdenes de fabricación con riesgo de retraso. Como la API no ofrece exactamente la información que necesita, decide calcular ese riesgo combinando fechas de entrega y operaciones pendientes.
Meses después actualizamos la lógica de planificación para tener en cuenta también la disponibilidad de materiales. Las pantallas estándar utilizan el nuevo cálculo, pero la personalizada sigue aplicando el suyo. Ningún contrato se ha roto, todo compila y, sin embargo, ahora tenemos dos versiones distintas de qué órdenes están en riesgo.
Un desarrollador podría haber cometido exactamente el mismo error. Pero si empezamos a generar muchas más interfaces, también multiplicamos este tipo de inconsistencias. La conclusión parece obvia: las interfaces no deben reimplementar reglas de negocio. Si el SDK o la API no ofrecen una capacidad necesaria, lo correcto es ampliar ese contrato en lugar de introducir lógica paralela.
Conviene ser honesto con lo que eso implica, porque choca con otro de mis objetivos. Quiero que las personalizaciones no toquen el núcleo del producto, y a la vez quiero que cualquier dato o cálculo nuevo que necesiten se añada al contrato del núcleo. Las dos cosas no pueden ser ciertas para todas las personalizaciones. Cada vez que una pantalla necesite algo que la API no da, alguien tendrá que decidir si esa necesidad justifica tocar el contrato, y mientras tanto el incentivo del agente, o de un equipo de implantación con prisa, será calcularlo en local. El ejemplo de las órdenes en riesgo no es un accidente: es lo que produce esa tensión cuando nadie la gestiona. Hará falta un criterio explícito sobre qué entra en el contrato, quién lo decide y quién paga ese coste, y hará falta que el agente sepa que calcular en local es la opción que necesita justificación, no la opción por defecto.
Hay dos cosas más que una pantalla generada puede hacer mal sin que nada se rompa. La primera es la autorización: una interfaz que combina ventas, existencias y compras tiene que respetar qué puede ver cada usuario, y «usar el SDK» no lo garantiza si el SDK expone capacidades y la pantalla decide cómo combinarlas. La segunda es el rendimiento: diez llamadas a la API donde bastaba una, algo que un agente hará sin dudar si nadie se lo impide y que en un producto multi-tenant se nota rápido.
Y para comprobar que todo esto se respeta necesitaremos pruebas que validen el comportamiento del sistema, no solo que el código generado funciona. Aquí está, creo, la pregunta que decide si todo lo anterior se sostiene: ¿quién escribe esas pruebas para una pantalla que encarna la necesidad concreta de una fábrica? Si las escribe el mismo agente que escribió la pantalla, lo que prueba es su propia interpretación. Parte de la respuesta estará en pruebas que pertenezcan al contrato y no a la personalización (si la API dice que una orden está en riesgo, cualquier pantalla que la muestre de otra forma falla), y parte tendrá que venir de las personas que conocen el proceso real.
No sabemos todavía hasta qué punto ese mantenimiento podrá automatizarse de manera fiable y rentable a gran escala. Pero tampoco parece razonable calcular su coste futuro suponiendo que cada personalización seguirá requiriendo las mismas horas humanas que hoy. Esa es la hipótesis interesante: la IA podría cambiar no solo el coste de producir software personalizado, sino el de conservarlo a lo largo del tiempo. Y si no cambia el coste de verificarlo, no habrá cambiado lo suficiente.
De una pantalla puntual a una funcionalidad del producto
Hay una consecuencia que me interesa especialmente. Quizá no tengamos que decidir de antemano si una interfaz será temporal, personalizada o estándar.
Una persona podría pedir una visualización para resolver una duda puntual y descartarla después. Si le resulta útil cada semana, podría conservarla. Si todo su equipo necesita lo mismo, podrían compartirla. Y si descubrimos que responde a una necesidad común a muchos clientes, quizá merezca convertirse en una funcionalidad del producto, diseñada y mantenida centralmente.
Detectar necesidades comunes entre clientes no es nuevo; es lo que hacemos con las peticiones de soporte y las solicitudes de funcionalidades. Lo que cambiaría es la calidad de la señal. Una petición describe lo que alguien cree que necesita; una personalización que lleva meses en uso describe lo que alguien ha construido y sigue utilizando para resolver un problema real. Es una evidencia mucho más sólida para decidir dónde invertir.
Ese paso no debería ser automático. Que varias empresas construyan algo parecido no demuestra que sea la mejor solución, y para detectar esas coincidencias necesitaríamos patrones de uso, feedback o un registro de las necesidades que motivaron cada personalización, sin asumir que podemos inspeccionar libremente el código o los datos de nuestros clientes. Y una pantalla muy utilizada por una sola fábrica no tiene por qué acabar en el producto estándar: puede seguir siendo una personalización perfectamente válida mientras mantenerla resulte razonable.
Lo que queremos explorar en Bold
Esta discusión nos toca de cerca. En Bold desarrollamos software de operaciones industriales, y vemos constantemente que dos fábricas con procesos parecidos necesitan trabajar de formas muy distintas. Hasta ahora hemos tenido que equilibrar un producto común y mantenible con adaptaciones cuyo coste no siempre se justifica para una pyme.
Lo primero que nos interesa explorar no es que cada operario pueda generar cualquier pantalla, sino abaratar las personalizaciones durante la implantación. Que nuestro equipo pueda construir, con ayuda de agentes, experiencias adaptadas a cada fábrica sin modificar el núcleo de Bold, y con un criterio claro sobre cuándo una necesidad sí justifica ampliar el contrato. Más adelante tendría sentido permitir que los propios clientes soliciten cambios, probablemente empezando por un alcance limitado y con mecanismos de aprobación.
Un primer experimento podría ser crear para un jefe de turno una pantalla que reúna órdenes urgentes, disponibilidad de máquinas e incidencias, sin incorporar esa combinación al producto estándar. Para que el experimento sirva de algo, habría que fijar de antemano qué medimos: el tiempo que tarda en resolver sus tareas habituales con y sin la pantalla, las consultas de soporte que genera, y las horas que cuesta mantenerla tras tres o cuatro versiones del producto. Si no cerramos esos números antes de empezar, acabaremos con la sensación de que funciona y sin saber lo que cuesta.
Para las interfaces persistentes, nuestra idea es que vivan dentro de Bold y utilicen componentes y capacidades de la propia plataforma. Eso no impide que un asistente externo pueda operar Bold a través de APIs o herramientas como MCP, e incluso mostrar sus propias interfaces temporales. Es la respuesta a la tensión comercial de la que hablaba al principio: las pantallas que se repiten y se comparten viven en nuestro producto; las exploratorias pueden vivir donde el usuario esté, y lo que las une es el contrato, no el SDK visual.
Seguimos teniendo preguntas abiertas: cómo validar los cambios funcionales, qué nivel de personalización podremos soportar y cuál será su coste real de mantenimiento. No tenemos una respuesta demostrada para todo ello ni queremos presentar esta arquitectura como un problema ya resuelto. Precisamente por eso merece la pena investigarla.
¿Qué interfaces merece la pena diseñar y mantener?
Después de darle todas estas vueltas, creo que la respuesta depende principalmente de la frecuencia con la que utilizamos una interfaz, de cuántas personas necesitan algo parecido y del tipo de tarea que queremos resolver.
Para una consulta excepcional o un análisis exploratorio, tiene sentido generar una interfaz temporal y descartarla después. Si es algo que una empresa o un departamento utiliza habitualmente, una personalización persistente puede aportar mucho valor. Y si esa necesidad es común a numerosos clientes, seguramente merezca convertirse en una funcionalidad diseñada y mantenida como parte del producto estándar.
Esa respuesta, dicha así, no es nueva. Antes de los agentes ya decidíamos de la misma manera. Lo que cambia es dónde están los umbrales: si antes una personalización necesitaba un cliente grande o una docena de usuarios para justificarse, quizá ahora baste con un departamento o con un solo rol en una fábrica. La pregunta de fondo es si el coste de verificar y mantener baja en la misma proporción que el coste de construir, porque si no lo hace, habremos movido el umbral de lo que podemos crear sin mover el de lo que podemos sostener.
Cuanto más fácil sea construir y modificar software, más valor tendrán los contratos claros, el versionado y las pruebas. La IA no sustituye a la buena ingeniería; cambia cuánto podemos construir y mantener cuando la hacemos bien. Y si conseguimos eso, quizá podamos personalizar mucho más sin renunciar a lo que hace útil una buena aplicación: que sea comprensible y predecible para quienes trabajan con ella.
La personalización total no tiene por qué significar inconsistencia total.
Fuentes
- OpenAI, «GPT-6 e interfaz inteligente para todos»: asistentes generalistas que responden con interfaces interactivas (botones, formularios, gráficos) en lugar de solo texto.
- SAP, Clean core extensibility for SAP S/4HANA Cloud: enfoque Clean Core, extender el ERP sin comprometer las actualizaciones del núcleo.
- Model Context Protocol, especificación: protocolo abierto con el que un asistente externo puede usar los datos y las herramientas de otra aplicación.
- Model Context Protocol, MCP Apps: extensión que permite a un asistente mostrar interfaces interactivas dentro de la propia conversación.